从模型归因读出化学意义
有用的解释应连接 明确区域 → 物理量 → 有模型证据的趋势 → 可检验的假设。 先看硫中心问题,再用下方可下载的真实教学输出练习读归因。
1. 一个硫中心问题
问题是:考虑全分子的尺寸与暴露程度后,硫附近的静电环境是否仍能帮助区分添加剂? 在建模前选定硫;六个结构见 案例二:含硫分子表面流程。
S_ESP_average 的含义可以直接读懂:选出 S 原子,读取各自分配原子表面的平均 ESP,
再对这些 S 原子的数值取均值。公开提取器读取 ESP All average (kcal/mol),
实现在 surfacia/features/atom_properties.py。它 不是硫原子电荷。
如果有多个 S 原子,当前实现对原子级统计量取均值;其 min/max 列不等同于
所有 S 表面点合在一起的全局极值。
一张解释卡回答四个问题:
在哪里? 分配给硫的表面区域,保留原子编号。
是什么? ESP、生成程序的单位,以及明确的聚合规则。
模型显示了什么? 重要性、带符号的 SHAP 趋势、数据范围、覆盖与离散程度;同时核对全分子变量。
怎样检验? 比较局部环境不同而尺寸、形状尽量相近的分子,并独立测量目标。
这里展示化学问题和读图模板,不是新的电催化结果。 孤立分子描述符本身不能证明吸附构型、添加剂与 Cu 的作用机理或因果选择性规律。
共同有机催化核心可按相同思路换成预先定义的片段。 没有明确先验的溶解度问题则应同时比较通用描述符,不能预设局部表面表示总是最有用。
2. 读取一个真实输出
下面的数字来自 案例一:描述符建模与 SHAP 的可下载运行:36 个公开结构、六个 RDKit 特征, 目标是 计算的 Crippen logP。这个轻量练习教的是读归因,不是量子表面案例。
字段 |
数值与含义 |
|---|---|
SMILES |
CCCCCO |
RDKit Crippen logP |
1.1689 |
预测 |
1.2970 |
MolWt |
88.15 g/mol; SHAP +0.5745 |
TPSA |
20.23 A²; SHAP -0.2817 |
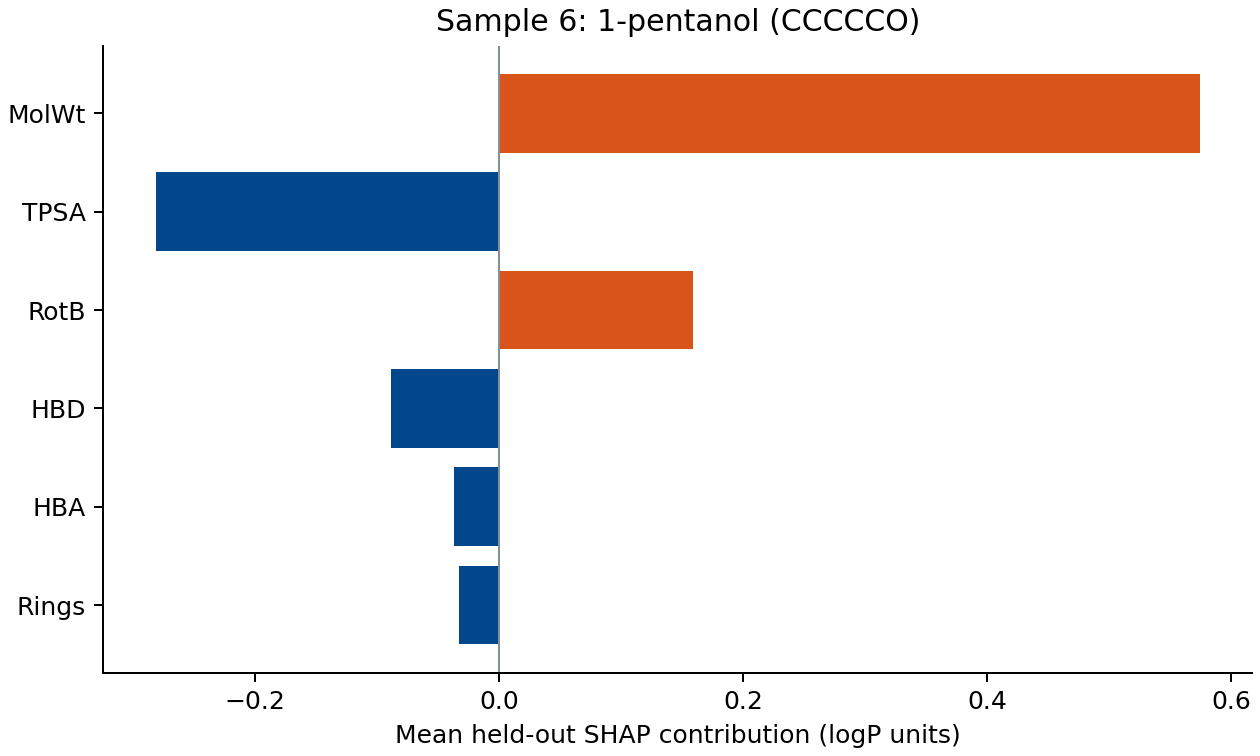
分子量项相对模型基线推高预测,TPSA 项拉低预测。应同时查看六项贡献,而不是把某一项写成机理。
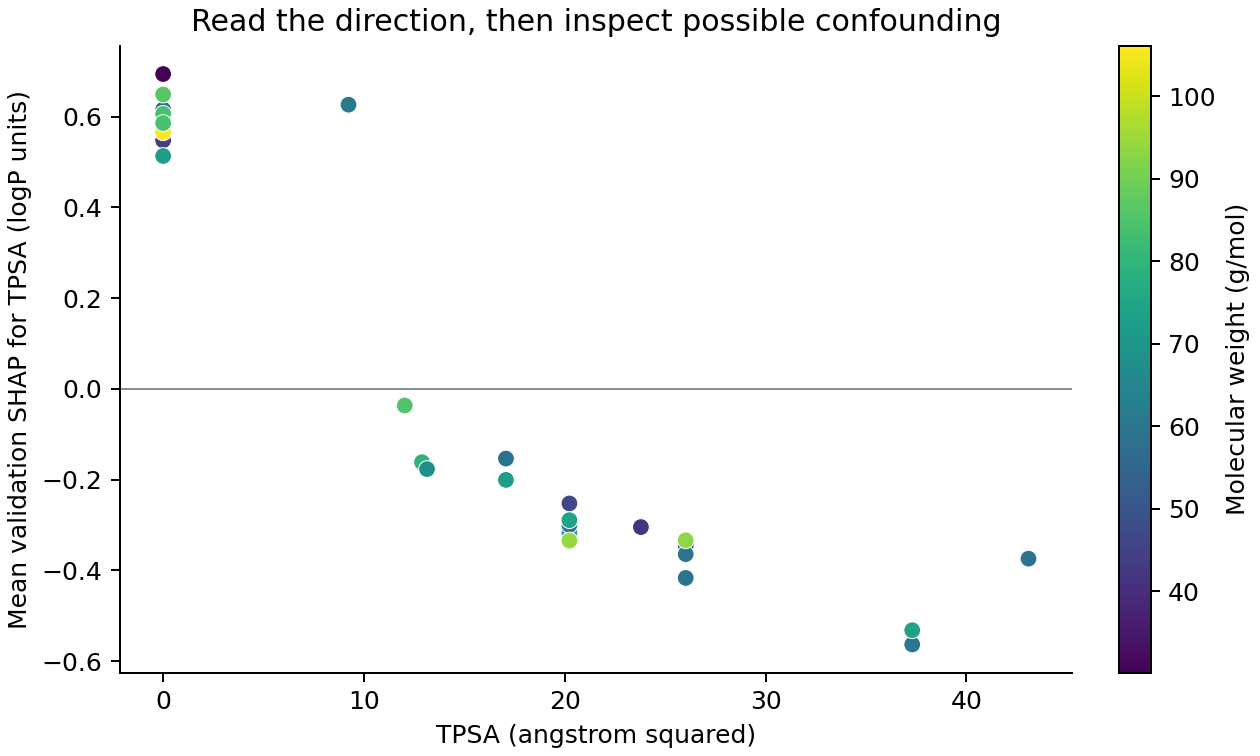
在建模池中核对方向及可能的尺寸混杂。依赖图是观察性证据,不代表单独改变 TPSA 的干预实验。
mean(abs(SHAP)) 表示影响大小,带符号的 SHAP 表示相对模型基线的方向,
SHAP_Std_* 表示模型间离散程度,不是校准置信区间。
SHAP 为正也不表示这种结构改动对所有分子都有利。
这个小教学集的留出 R² 只有 0.076,解释卡不能用来证明泛化能力或实验精度。
交互查看同一组数据
按上述名称保存两个 CSV,创建空目录 structures。
SMILES 提供二维结构;三维表面视图需要真实表面文件。
surfacia shap-viz -i Training_Set_Detailed_demo.csv -x ./structures --test-csv Test_Set_Detailed_demo.csv --skip-surface-gen --host 127.0.0.1 --port 8052
打开 http://127.0.0.1:8052,选择 TPSA 或 MolWt,再选样本 6,比较结构、数值与归因。 本地图表不需要 API 密钥。
3. 从可读的解释卡走向研究证据
最新文章分别评价预测与可解释性。研究流程增加了冻结共享划分、仅在验证样本上计算归因、 XGBoost/TreeSHAP 与 MLP/DeepSHAP、扰动检验和盲化 LLM 评价。 MLP 的 SHAP 背景只取自相应训练折。 这些属于独立研究脚本,不是公开可视化工具的几个附加开关。
六个评价问题是:化学语义、映射明确性、归因证据支持、跨模型稳健性、实验可检验性、 主张边界控制。LLM 读取固定的匿名证据卡进行评价,不生成量子描述符,也不替代实验验证。 LLM 偏好可以作为解释效用的证据,不能证明机理正确或达到人工专家等效性。
可以将这套检查思路用于自己的数据。教学例没有执行 MLP、扰动检验或 LLM 评分, 也不分发未发布的研究表格和稿件图片。 完整路径见 工作流:始终围绕化学问题,字段说明见 读取预测与解释输出。